Wie KI die Ökobilanzierung und die Berechnung des Product Carbon Footprints revolutioniert
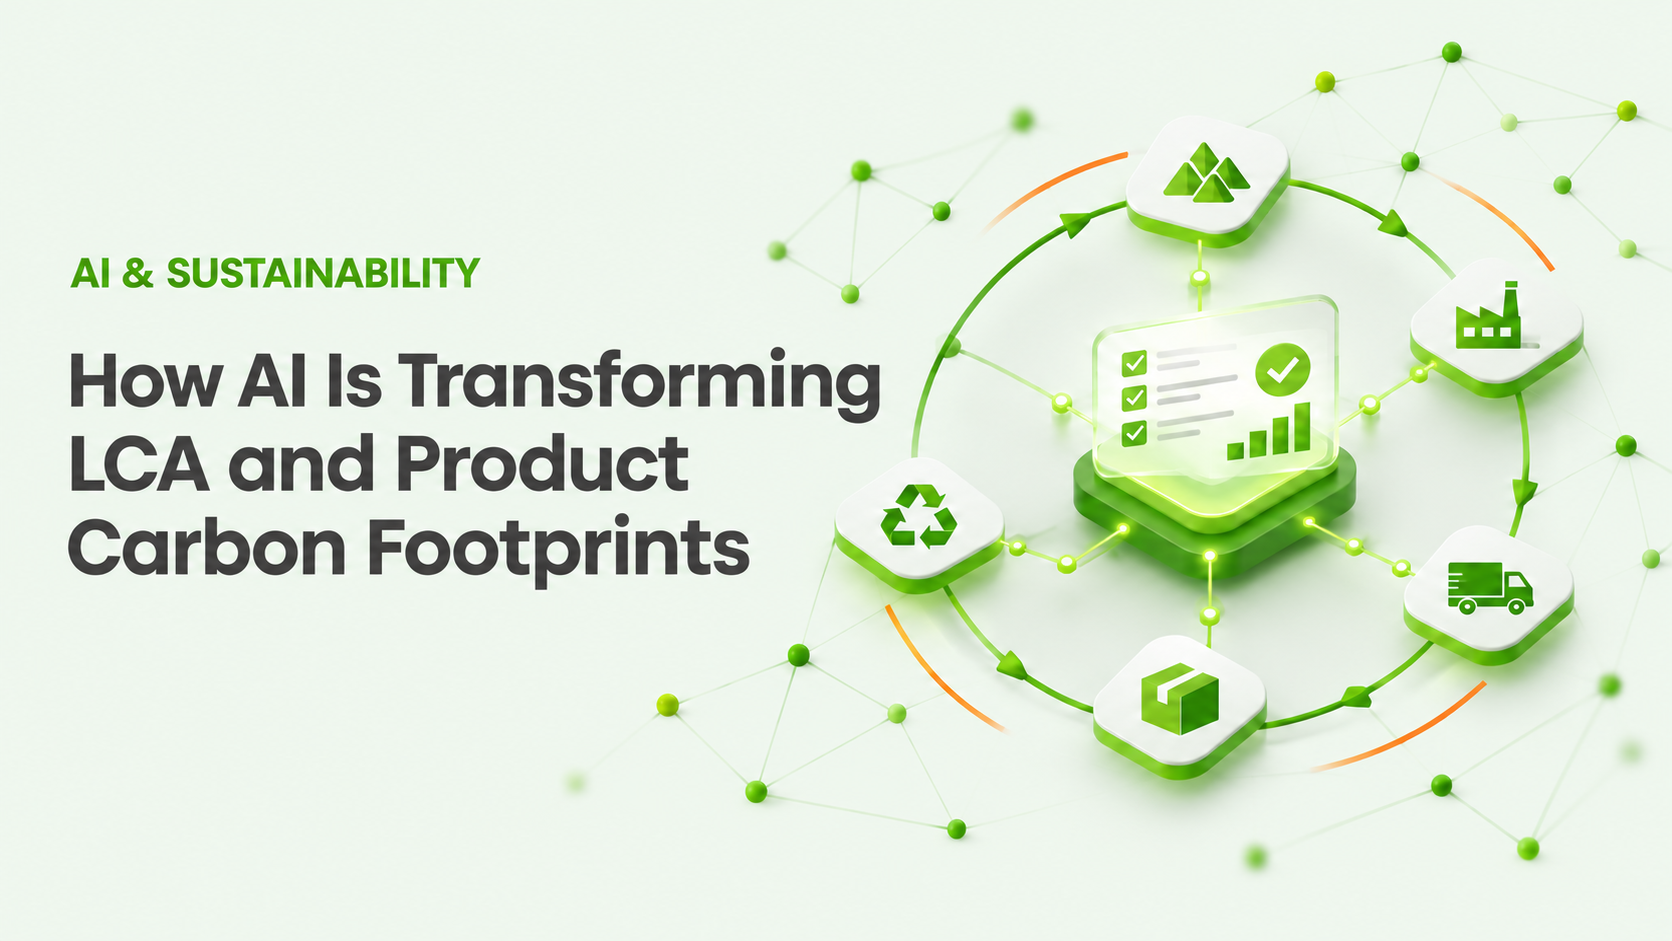
Mehr als nur KI-Hype: Wie sich der Engpass bei LCI-Daten lösen lässt
Wenn es um KI im Nachhaltigkeitsbereich geht, dreht sich die Diskussion häufig um die CO₂-Bilanzierung von Unternehmen – etwa um die Erfassung von Energieverbrauchsdaten für Scope-1- und Scope-2-Emissionen oder die Kategorisierung von Ausgabenbelegen.
Wer jedoch direkt an Ökobilanzen (Life Cycle Assessments, LCA) und Product Carbon Footprints (PCFs) arbeitet, kennt den eigentlichen Engpass: Es fehlt an Hintergrunddaten für Sachbilanzen (Life Cycle Inventory, LCI), und der Aufbau entsprechender Datenbanken ist zeitaufwendig.
Unser Datenteam bei sustamize stellt sich dieser Herausforderung: Wir bauen eine eigene KI-gestützte LCI-Datenbank auf und entwickeln eine KI-basierte Plattform für LCA-Daten. Dabei erleben wir aus erster Hand, wie KI über den Hype hinaus zur Grundlage für skalierbare Ökobilanzen werden kann.
Die größte Herausforderung bei Ökobilanzen: fehlende LCI-Daten und manuelle Zuordnung
Die Berechnung eines präzisen Product Carbon Footprints entlang komplexer Lieferketten ist eine große Herausforderung. Ein Grund dafür ist, dass die benötigten Daten in unterschiedlichsten Formaten vorliegen, etwa als unstrukturierte PDFs von Lieferanten, Rohstoffspezifikationen oder unvollständige Stücklisten (Bills of Materials, BOMs).
Traditionell müssen LCA-Fachleute jedes Dokument manuell auswerten, nach geeigneten Sekundärdatensätzen suchen und jeden einzelnen Prozessfluss zuordnen. Das ist langsam, mühsam und schwer zu skalieren, wenn ein Unternehmen Hunderte von Produkten im Sortiment hat.
Hinzu kommen große Lücken bei sekundären LCI-Daten für regionale Lieferketten und neue Fertigungsverfahren. Fachleute müssen deshalb teilweise Annahmen treffen oder auf wenig passende Ersatzdatensätze zurückgreifen.
Wie kann KI Sachbilanzdaten (LCI-Daten) generieren?
Wir betrachten KI nicht als einfache Abkürzung, die aus einer Eingabe ein Ergebnis errät. Stattdessen nutzen wir sie, um strukturierte Vordergrundprozesse auf Ebene einzelner Prozessschritte zu erstellen. Diese bilden die Grundlage für eine wiederverwendbare Hintergrunddatenbank.
Mehr über unseren Ansatz erfahren Sie in unserem Blogbeitrag zur KI-gestützten Generierung von LCI-Daten.
1. Vordergrundprozesse auf Ebene einzelner Prozessschritte erstellen
unächst unterstützt KI dabei, einzelne Vordergrundprozesse zu definieren und zu strukturieren. Dazu gehören die spezifischen Inputs, Outputs, Emissionen und Ressourcenflüsse einer Aktivität.
2. Methodik und festgelegte Regeln prüfen
Während die Einzelprozesse erstellt werden, prüft die KI sie kontinuierlich anhand klar definierter methodischer Regeln. So wird sichergestellt, dass unsere Abschneidekriterien, Systemgrenzen und Allokationsprinzipien eingehalten werden.
3. Eine wiederverwendbare LCI-Prozessdatenbank aufbauen
Sobald ein Einzelprozess generiert und validiert wurde, wird er zu einem modularen, wiederverwendbaren Baustein unserer LCI-Prozessdatenbank. Diese Daten können anschließend für unterschiedliche Materialien, Produkte und Lieferkettenmodelle verwendet werden.
4. Ökobilanzen und Product Carbon Footprints automatisiert berechnen
Auf Grundlage einer robusten, regelbasiert geprüften LCI-Prozessdatenbank können präzise LCA-Berechnungen für ganze Produktportfolios automatisiert durchgeführt werden.
Die entscheidende Frage: Wie lassen sich KI-generierte LCI-Daten überprüfen?
Bei der Modellierung von Ökobilanzen können „Halluzinationen“ oder ungeprüfte Annahmen schwerwiegende Folgen haben. Wenn ein KI-System fehlerhafte Prozessflüsse generiert und dabei strenge Standards nicht einhält, leidet die Aussagekraft der gesamten Bewertung.
Indem wir methodische Prüfungen direkt in die Prozessgenerierung integrieren, stellen wir die Überprüfbarkeit sicher:
- Automatisierte Prüfung von Regeln: Systemgrenzen, Allokationslogik und Abschneidekriterien werden algorithmisch überprüft, bevor Daten finalisiert werden.
- Validierung durch Fachleute: Zertifizierte LCA-Fachleute behalten die Kontrolle und überprüfen Prozessflüsse mit geringer Zuverlässigkeit sowie komplexe Allokationsentscheidungen.
- Einhaltung von ISO 14040 und ISO 14044: Datenqualitätsindikatoren, darunter die zeitliche, geografische und technologische Repräsentativität, werden für jeden einzelnen Prozess transparent erfasst.
Die Grenzen von KI in der Ökobilanzierung: Transparenz statt Perfektion
Wir müssen ehrlich über die Technologie sprechen: KI ist nicht fehlerfrei. Fehler und Halluzinationen sind weiterhin möglich, und ein offener Umgang mit diesen Herausforderungen hat für uns höchste Priorität. Insbesondere sind nicht alle Prozessdetails im Internet verfügbar und damit für KI auffindbar.
Gleichzeitig müssen wir auch eine weitere Herausforderung ansprechen: Die Branche verlässt sich heute häufig auf veraltete Marktdurchschnittswerte und generische LCI-Datensätze, die moderne Technologien nicht ausreichend abbilden. Das kann zu fehlerhaften Entscheidungen und unrealistischen Szenarien führen.
Um vom Reporting zum tatsächlichen Klimaschutz zu gelangen, müssen wir Produkte aus der Perspektive des Produktdesigns und Cost Engineerings betrachten. Mit unserem Ansatz möchten wir eine echte Alternative schaffen, die dabei hilft, LCA- und PCF-Daten in konkrete Maßnahmen zu übersetzen.
Die Zukunft KI-gestützter LCI-Datenbanken und skalierbarer Ökobilanzen
KI für die Weiterentwicklung von LCI-Daten zu nutzen, bedeutet nicht, eine fehlerfreie „Blackbox“ zu versprechen, die Nachhaltigkeitsprobleme über Nacht löst. Es geht darum, einen disziplinierten, kontinuierlichen Ansatz aufzubauen: Software beschleunigt die Erstellung von Einzelprozessen, Algorithmen sichern die methodische Sorgfalt und menschliche Fachleute gewährleisten die wissenschaftliche Qualität.
Indem wir offen über Genauigkeitsgrenzen sprechen und gleichzeitig Datenengpässe systematisch angehen, kommen wir einer Zukunft näher, in der zuverlässige, hoch aufgelöste LCA-Daten in der Geschwindigkeit und im Umfang verfügbar sind, die unser Planet braucht.
Auch wenn auf diesem Weg zunächst Fehler oder Halluzinationen auftreten können, werden wir die Möglichkeiten automatisierter, hoch aufgelöster Prozessdaten kontinuierlich weiterentwickeln.

14 Tage kostenlos testen
Entdecke unsere Emissionsdatenbank, KI-gestützten Tools und Lösungen für die Erstellung von Product Carbon Footprints.


Emissionen senken,
Kosten optimieren
CO₂e-Daten nutzen, um Product Carbon Footprints entlang der Wertschöpfungskette effizient zu berechnen und zu optimieren.
©2026 sustamize | AGB | Datenschutz | Impressum.